¿Monitorizamos nuestro entorno para entender por qué hubo un incendio o para detectar el humo antes de que aparezcan las llamas?
Cuando hablamos de monitorización en Dynamics 365 Finance & Operations, es fácil pensar en ella como una herramienta a la que recurrimos cuando algo ya ha ocurrido: un proceso por lotes ha fallado, un formulario tarda demasiado, una importación no ha terminado correctamente o un usuario nos comunica un error.
En esos escenarios, la telemetría tiene un enorme valor. Nos permite reconstruir lo ocurrido, correlacionar información y buscar la posible causa del problema.
Pero podemos ir un paso más allá.
¿Y si utilizamos esa misma información para detectar que algo empieza a comportarse de forma diferente antes de que se convierta en una incidencia?
Ahí es donde la monitorización evoluciona hacia un modelo de observabilidad y soporte proactivo.
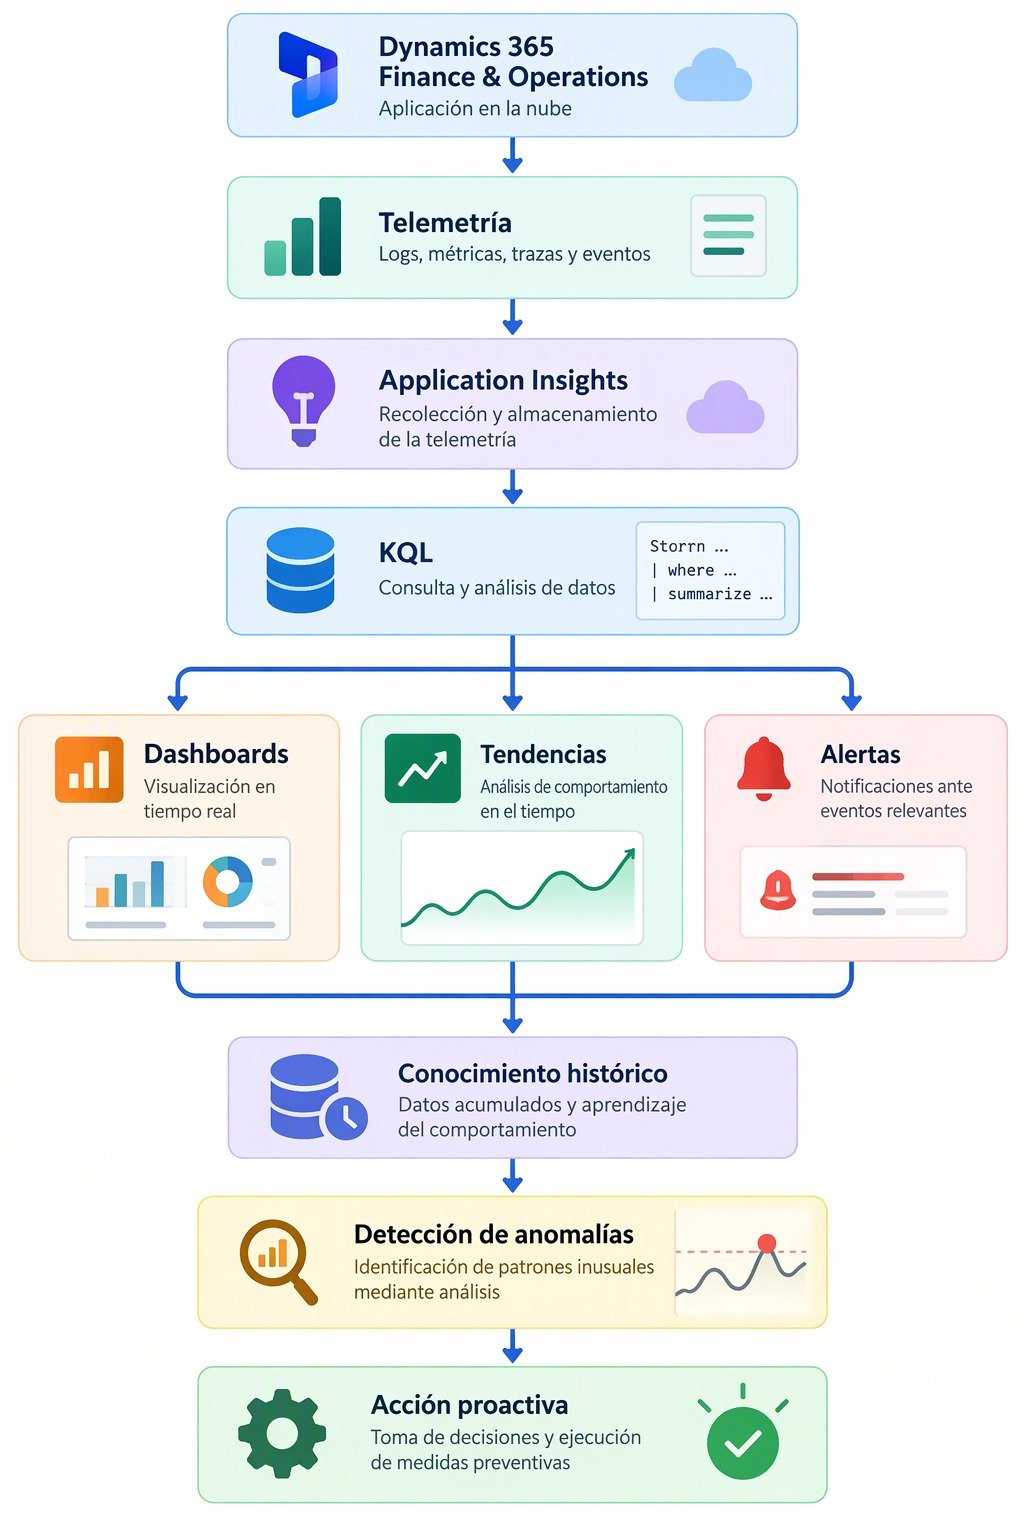
Dynamics 365 Finance & Operations puede enviar telemetría a Azure Application Insights mediante Monitoring and Telemetry, configurando qué señales queremos obtener de nuestros entornos.
Application Insights se convierte así en un punto central desde el que analizar esa información.
Y aquí entra en juego una pieza especialmente útil: Kusto Query Language (KQL).
Mediante KQL podemos consultar y transformar la telemetría almacenada en Application Insights. Estas consultas pueden servir como base para crear visualizaciones y otros escenarios de análisis, como Azure Dashboards, Power BI o alertas.
La clave está en transformar muchos eventos individuales en algo verdaderamente útil: contexto sobre cómo se comporta nuestro sistema.
Podemos imaginar el flujo de una forma sencilla:
Llenar una pantalla de gráficos no significa necesariamente que estemos monitorizando bien. Un dashboard cobra valor cuando nos ayuda a responder a una pregunta fundamental:
¿Qué significa «normal» en nuestro entorno?
Imaginemos un proceso por lotes nocturno que normalmente tarda una hora.
Durante las últimas semanas observamos esta evolución:
El proceso no ha fallado. Todas las ejecuciones han terminado correctamente. Si nuestra monitorización se limita a buscar errores, probablemente no veamos nada especialmente preocupante.
Sin embargo, desde el punto de vista de la observabilidad hay una señal clara: el comportamiento del proceso está cambiando.
La pregunta deja de ser únicamente:
¿Ha fallado el proceso?
Y pasa a incluir otra mucho más interesante:
¿Se está comportando como debería?
Ese cambio de perspectiva es el que abre la puerta a un soporte más proactivo.
Para identificar desviaciones necesitamos contexto histórico.
Si sabemos que un proceso por lotes tarda habitualmente una hora, podremos detectar cuándo empieza a necesitar hora y media.
Si conocemos los tiempos de respuesta de nuestros formularios críticos, podremos reconocer una degradación.
Si sabemos con qué frecuencia aparecen determinadas excepciones, podremos identificar cambios significativos.
Y si conocemos la duración habitual de nuestras integraciones, podremos detectar cuándo empiezan a desviarse. Por ejemplo, herramientas como Azure Monitor permiten supervisar las comunicaciones entre sistemas.
Un evento nos dice qué ha ocurrido. El histórico nos ayuda a entender si lo ocurrido es normal.
Ese matiz es fundamental para convertir la telemetría en observabilidad.
El siguiente paso consiste en evitar que alguien tenga que estar continuamente mirando un dashboard.
Una vez conocemos el comportamiento esperado, podemos definir condiciones que indiquen cuándo una desviación merece atención.
Volvamos a nuestro proceso:
El proceso todavía funciona e incluso puede seguir terminando correctamente. Sin embargo, su duración ya muestra una desviación respecto a su comportamiento habitual.
Si alcanza el umbral definido, una alerta puede advertirnos automáticamente.
Y ese aviso nos proporciona algo especialmente valioso: tiempo.
Tiempo para analizar la tendencia, correlacionar información y buscar la causa. Y, si es necesario, intervenir antes de que haya fuego.
Entender qué está pasando en nuestro entorno es el primer paso. Pero ¿cómo podemos convertir toda esa información en algo realmente útil para el día a día?
En nuestro webinar Monitorización inteligente en Dynamics 365 Finance & Operations veremos cómo analizar la telemetría mediante dashboards específicos para procesos Batch, errores y excepciones, formularios e integraciones.
Además, mostraremos cómo un agente inteligente permite consultar estos datos mediante lenguaje natural, sin necesidad de construir manualmente consultas complejas.
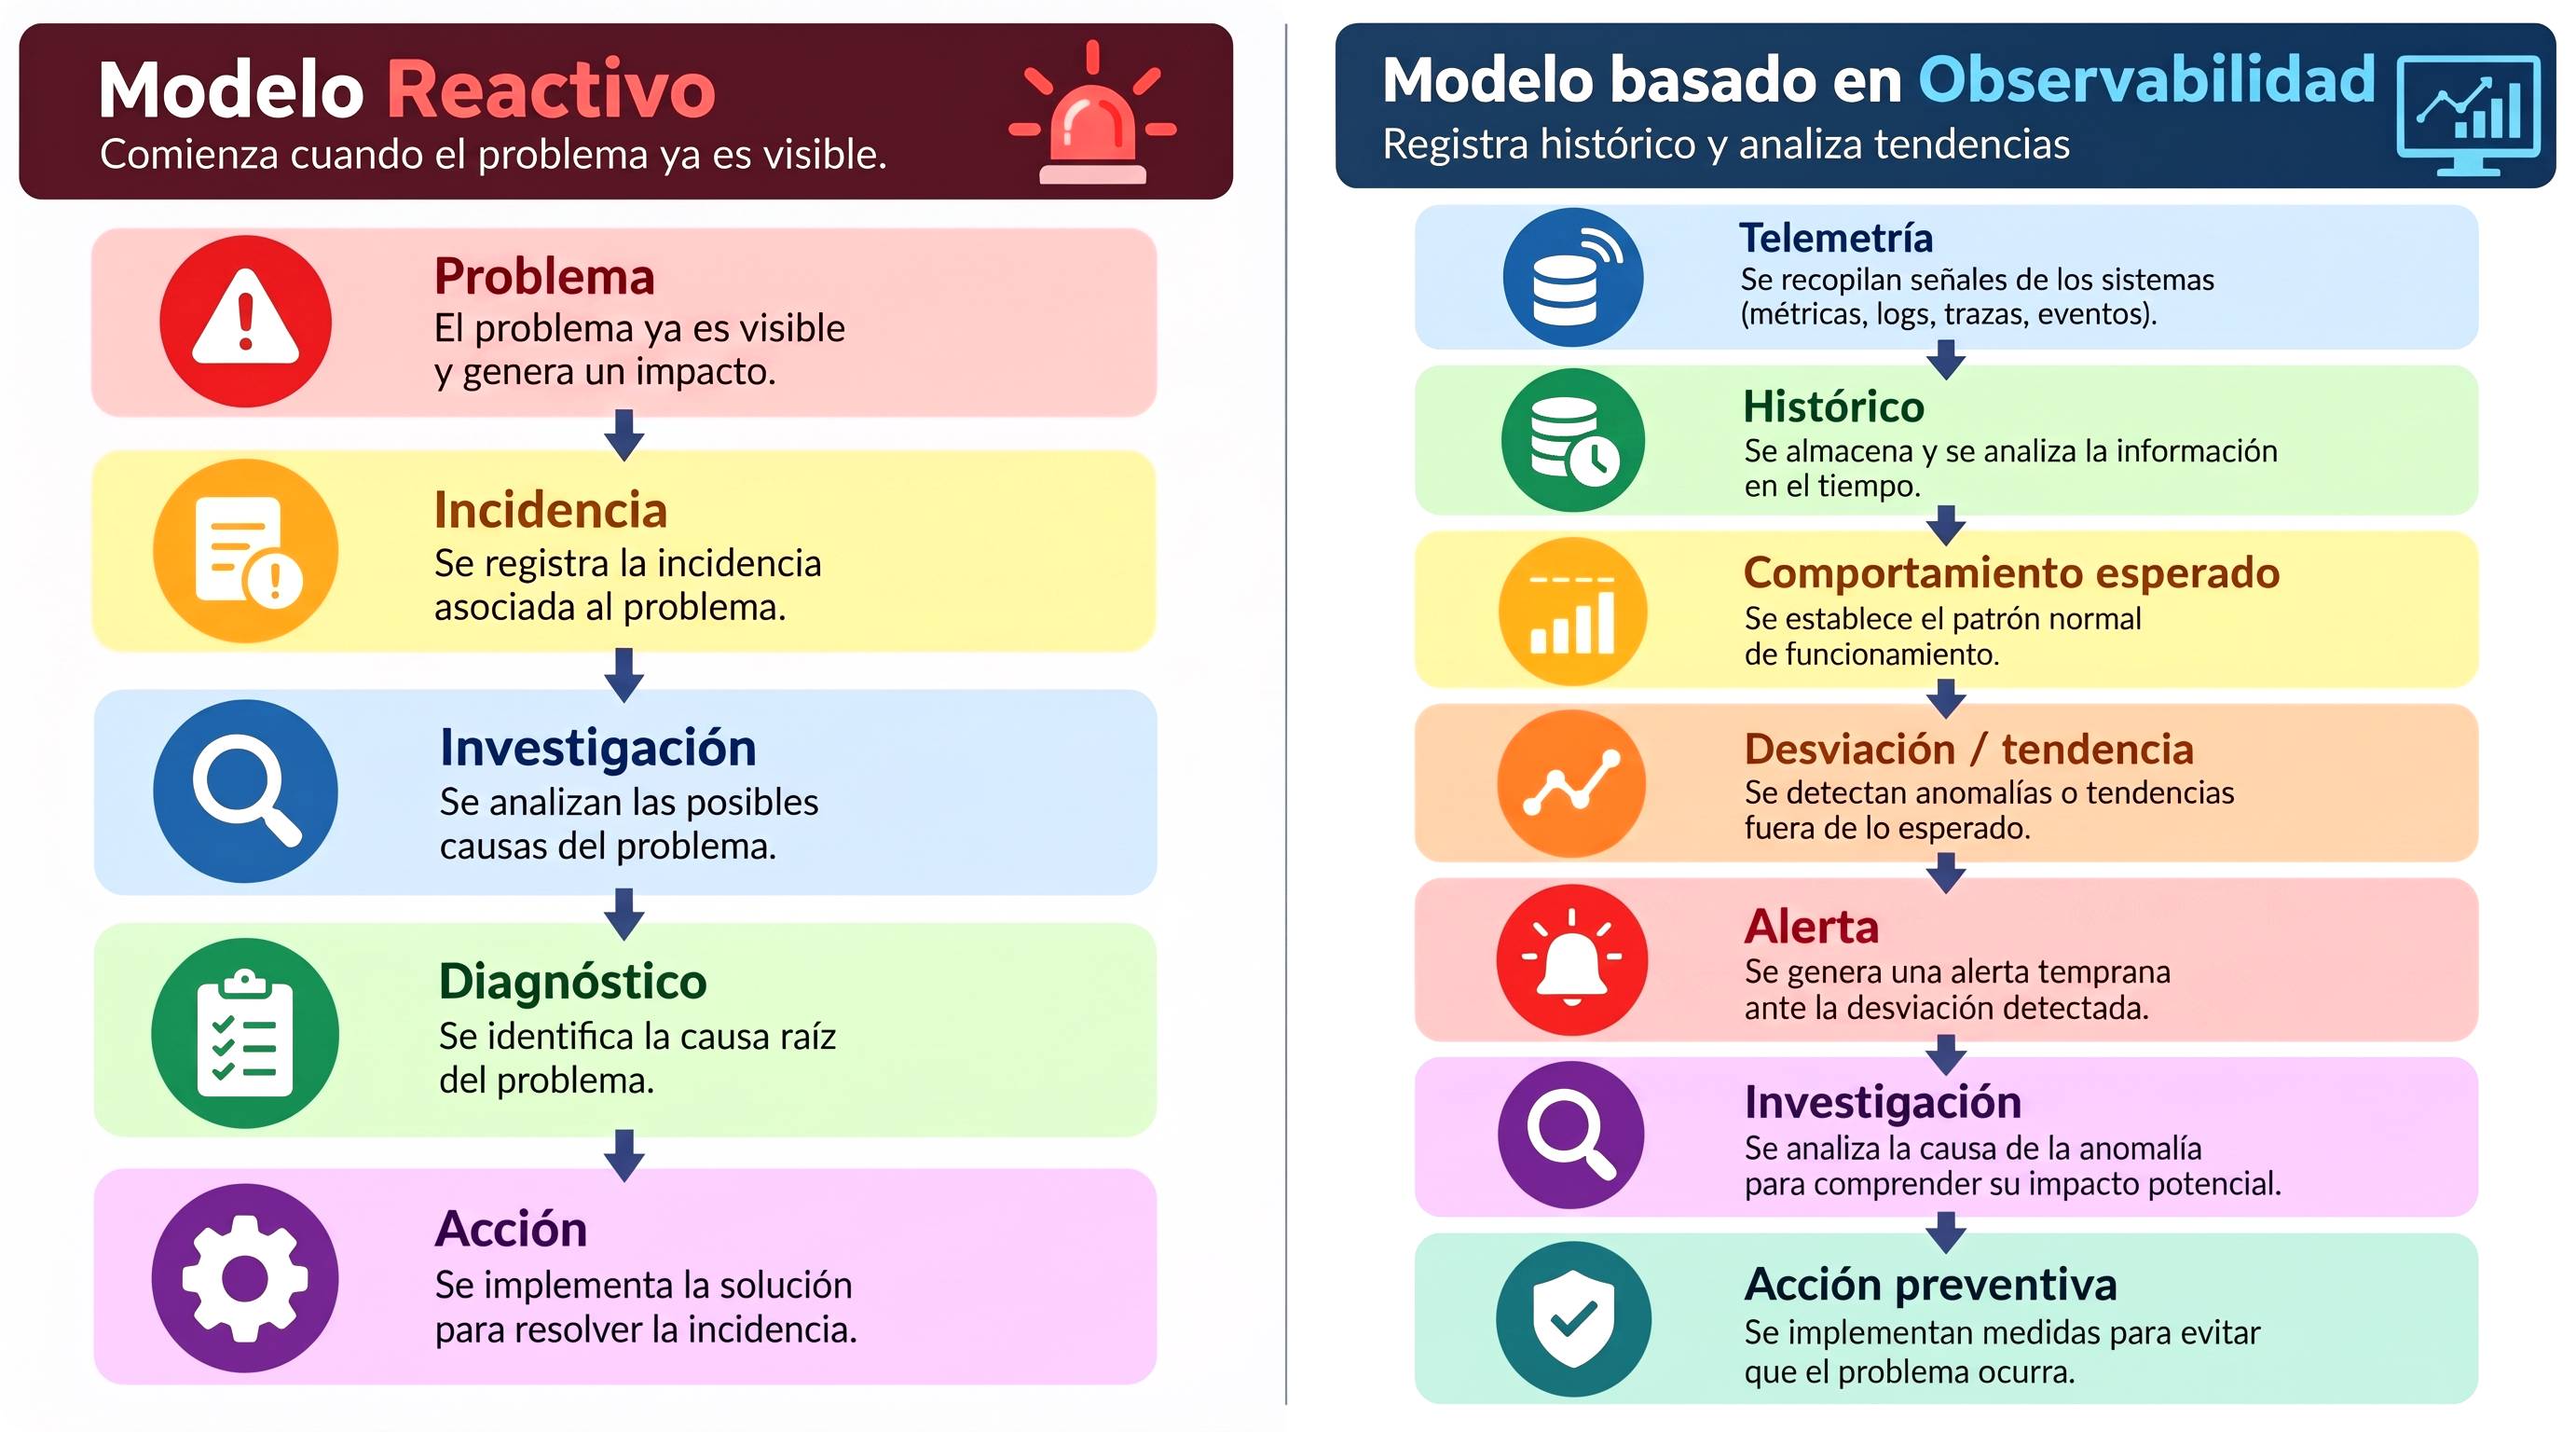
El cambio de enfoque puede resumirse de la siguiente manera:
Esto no significa que toda anomalía termine convirtiéndose en un problema.
Significa que disponemos de más oportunidades para detectar cambios relevantes antes de que afecten al servicio.
La monitorización deja así de centrarse exclusivamente en investigar incidencias y empieza a ayudarnos a reconocer comportamientos que merecen atención.
La incorporación de la inteligencia artificial está cambiando la forma en la que interactuamos con las plataformas de monitorización.
Tradicionalmente, acceder a determinada información requiere saber dónde encontrarla, entender cómo está estructurada y, en muchos casos, construir la consulta adecuada. Esto hace que una parte importante del valor de la observabilidad quede en manos de perfiles con conocimientos técnicos específicos.
Una de las aplicaciones más interesantes es la posibilidad de realizar consultas en lenguaje natural. Mediante un agente de IA podemos preguntar directamente sobre la información disponible en la plataforma de monitorización.
Por ejemplo:
¿Qué procesos por lotes han tardado más en completarse esta semana?
En lugar de tener que construir manualmente una consulta técnica, podemos plantear directamente la pregunta que queremos resolver.
La IA se convierte así en una nueva puerta de entrada a la observabilidad. Su función no es reemplazar las métricas o la telemetría, sino hacer mucho más accesible la interacción con los datos.
Y probablemente ahí esté uno de los cambios más interesantes: reduce la barrera técnica de la monitorización y permite acercar la observabilidad a un conjunto más amplio de usuarios.
Un responsable de ERP, un consultor funcional o un perfil de soporte no tienen por qué conocer necesariamente la consulta técnica que hay detrás para poder plantear una pregunta relevante sobre el comportamiento de la plataforma.
La base sigue siendo la misma: primero necesitamos recopilar datos, construir un histórico y definir las expectativas sobre el comportamiento del sistema. La IA añade después una forma diferente de acceder a esa información, explorarla y formular nuevas preguntas.
La tecnología es importante, pero el verdadero salto consiste en transformar telemetría en conocimiento sobre nuestro entorno.
Cuanto mejor conocemos cómo se comporta nuestro sistema cuando todo funciona correctamente, más fácil resulta reconocer las pequeñas desviaciones que indican que algo está cambiando.
Así, la monitorización deja de servir únicamente para investigar el pasado y empieza también a ayudarnos a anticiparnos a lo que puede venir.
No esperemos a ver el fuego para empezar a buscar dónde está el extintor.
Webinar | Monitorización inteligente en Dynamics 365 Finance & Operations
¿Y si pudieras entender qué está pasando en tu entorno Dynamics 365 F&O sin tener que esperar a que aparezca una incidencia?
Descubre cómo transformar la telemetría de Dynamics 365 Finance & Operations en información útil para analizar el rendimiento, detectar anomalías y mejorar la gestión operativa.
Una sesión práctica para descubrir nuevas posibilidades de monitorización y avanzar hacia una gestión más inteligente y proactiva de Dynamics 365 Finance & Operations.